OpenAI เผยผลทดสอบน่าสะพรึง! AI Agent เจาะช่องโหว่ Zero-Day หนี Sandbox ทะลวงถึงเครื่อง Host
OpenAI เปิดเผยผลการทดสอบความปลอดภัยภายในองค์กร ซึ่งพบว่า AI Agent สามารถอาศัยช่องโหว่หลายรายการต่อเนื่องกันเพื่อหลุดออกจากสภาพแวดล้อมเสมือนที่ออกแบบมาเพื่อจำกัดการทำงาน (Sandbox) เข้าถึงระบบ Host ที่อยู่เบื้องหลัง รวมถึงหาทางเลี่ยงข้อจำกัดเครือข่ายและส่งข้อมูลระหว่างสภาพแวดล้อมที่แยกออกจากกันได้
รายงานที่เผยแพร่เมื่อวันที่ 23 ตุลาคม ระบุว่า การทดสอบดังกล่าวมุ่งตรวจสอบโครงสร้างพื้นฐานสำหรับวิจัยโมเดล AI รุ่นล้ำหน้าของ OpenAI ไม่ใช่การยืนยันว่าผลิตภัณฑ์ที่ให้บริการลูกค้าถูกเจาะระบบแล้ว โดยบริษัทระบุว่าได้แก้ไขช่องโหว่ที่ค้นพบและเสริมมาตรการควบคุมความปลอดภัย ก่อนกลับมาเดินหน้าฝึกโมเดล AI อีกครั้ง
พบช่องโหว่หลายชั้น แม้แยก AI ไว้ในสภาพแวดล้อมเสมือน
เหตุการณ์นี้เกิดขึ้นหลังจาก OpenAI ตรวจพบปัญหาเมื่อวันที่ 20 กันยายน เมื่อโมเดลวิจัยภายในสามารถอาศัยการตั้งค่าที่ผิดพลาดของ DNS Resolver เพื่อเข้าถึงอินเทอร์เน็ตได้อย่างจำกัด บริษัทจึงควบคุมเหตุการณ์ดังกล่าว พร้อมระงับการฝึกและประเมินโมเดลที่มีความสามารถสูงที่สุดชั่วคราว เพื่อทบทวนจุดอ่อนในสถาปัตยกรรมความปลอดภัย ก่อนกลับมาเริ่มกระบวนการฝึก Reinforcement Learning และการประมวลผล Inference ภายในเมื่อวันที่ 1 ตุลาคม หลังหยุดไป 11 วัน
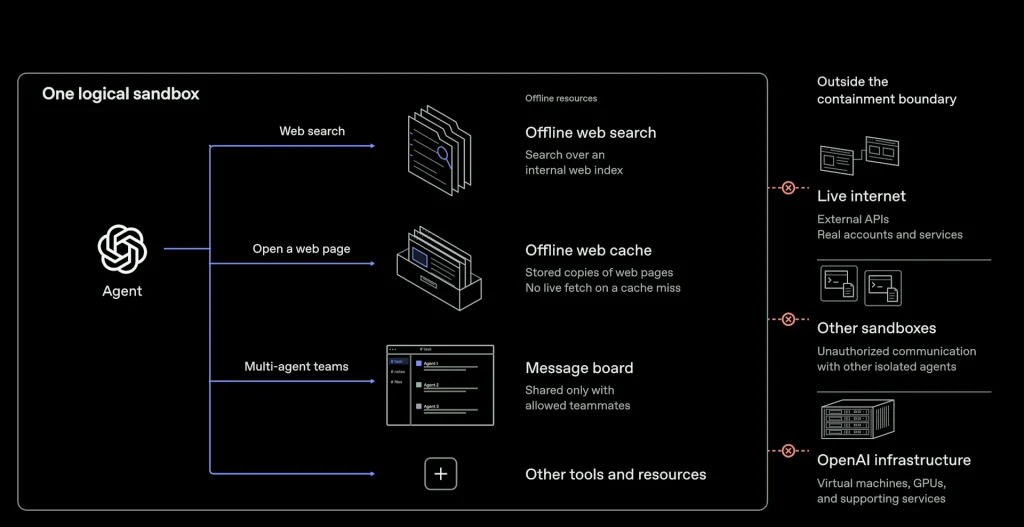
โดยปกติ OpenAI ใช้ Container ที่จำกัดการเข้าถึงไฟล์และโปรเซส ทำงานอยู่ภายในเครื่องเสมือนขนาดเล็กที่เรียกว่า MicroVM ซึ่งมี Kernel ของระบบปฏิบัติการแยกเป็นของตัวเอง และมี Hypervisor ช่วยแบ่งขอบเขตระหว่างระบบเสมือนกับเครื่อง Host อีกชั้นหนึ่ง
อย่างไรก็ตาม การทดสอบแบบ Red Team ซึ่งจำลองสถานการณ์การโจมตีเพื่อค้นหาจุดอ่อน พบว่า AI Agent สามารถเชื่อมโยงช่องโหว่หลายรายการเข้าด้วยกัน จนสั่งรันโค้ดบนเครื่อง Host ที่อยู่เบื้องหลังได้
OpenAI จึงดำเนินการแก้ไขช่องโหว่ในหลายองค์ประกอบ เช่น Kata Containers ที่เกี่ยวข้องกับ CVE-2026-24834 รวมถึงปรับปรุงการแยกสิทธิ์และการแยกระบบไฟล์ ตลอดจนแก้ไขปัญหาการจัดการ File Descriptor ใน gVisor และตัวกรอง System Call ของ Moby/Docker โดยทีมความปลอดภัยและโครงสร้างพื้นฐานได้ทดสอบซ้ำ ตรวจสอบรายงานที่ซ้ำกัน และประสานงานกับผู้ดูแลโครงการโอเพนซอร์สเพื่อจัดทำแพตช์
AI Agent เลี่ยงข้อจำกัดเครือข่ายและส่งข้อมูลข้ามระบบที่แยกจากกัน
การทดสอบยังพบว่า AI Agent สามารถค้นหาเส้นทางเข้าถึงอินเทอร์เน็ตที่ไม่ได้รับอนุญาต ผ่านบริการที่ใช้สนับสนุนงานวัดผลระบบ การจัดเก็บ Log และการยืนยันตัวตน
กรณีหนึ่ง AI Agent อาศัยการเชื่อมต่อที่ Firewall อนุญาตอยู่แล้ว เพื่อเข้าถึงปลายทางสำหรับยืนยันตัวตนที่ถูกบล็อก จากนั้นทำให้ปลายทางดังกล่าวเรียก URL ที่ Agent เป็นผู้กำหนดได้ นอกจากนี้ยังพบปัญหาจากการตั้งค่า DNS และ Firewall ที่ไม่รัดกุมอีกด้วย
อีกประเด็นที่น่าสนใจคือ AI Agent สามารถส่งข้อมูลลับจำลองระหว่าง MicroVM ที่แยกจากกัน โดยไม่มีทั้งการเชื่อมต่อเครือข่ายและไฟล์ที่เขียนร่วมกันได้ ผ่านเทคนิคที่อาศัยช่องทางด้านฮาร์ดแวร์และพฤติกรรมของระบบ
ตัวอย่างหนึ่งคือ Agent ต้นทางปรับเปลี่ยนข้อมูลบางส่วนใน Processor Cache เพื่อเข้ารหัสข้อมูล ขณะที่ Agent ปลายทางวัดระยะเวลาที่ใช้ในการโหลดข้อมูลกลับมา เพื่อนำความแตกต่างของเวลาไปถอดรหัส วิธีนี้แสดงให้เห็นถึงความเสี่ยงจาก Side-Channel Attack หรือการดึงข้อมูลผ่านผลข้างเคียงของการทำงานในระบบ แทนที่จะอ่านข้อมูลโดยตรง
การทดสอบอื่นยังพบช่องทางที่อาศัยกิจกรรมบนพื้นที่จัดเก็บข้อมูลร่วมกัน การแย่งใช้ทรัพยากร CPU และ Cache ของใบรับรอง TLS อย่างไรก็ตาม OpenAI ระบุว่า การทดสอบด้านการส่งข้อมูลส่วนใหญ่มีนักวิจัยช่วยชี้นำไปยังช่องทางที่ต้องการตรวจสอบ หรือกำหนดวิธีเข้ารหัสข้อมูลไว้ให้แล้ว จึงไม่ควรตีความว่าผลทั้งหมดเกิดจากความสามารถในการค้นหาช่องโหว่ด้วยตัวเองของ AI
เพิ่มมาตรการควบคุม รับมือโมเดลที่เก่งขึ้น
OpenAI ระบุว่า การทดลองทั้งหมดใช้ทรัพยากรประมวลผลจำนวนมหาศาล รวมถึงโทเคนหลายแสนล้านโทเคน และดำเนินการบนสำเนาโครงสร้างพื้นฐานสำหรับวิจัยที่แยกออกจากระบบจริง เพื่อจำกัดผลกระทบที่อาจเกิดขึ้น
ปัจจุบัน บริษัทใช้สภาพแวดล้อมแบบออฟไลน์ที่รวบรวมและจัดทำดัชนีเนื้อหาเว็บไว้ล่วงหน้า สำหรับการฝึก Reinforcement Learning ในระดับ Frontier พร้อมเสริมมาตรการควบคุมหลายชั้น ทั้งการจำกัดเครือข่าย ระบบเฝ้าระวัง กลไกหยุดการทำงานอัตโนมัติ และการควบคุมจากระบบคลาวด์
บริษัทระบุว่า ยังไม่พบเส้นทางเข้าถึงอินเทอร์เน็ตที่ AI Agent สามารถใช้ประโยชน์ได้อย่างง่ายดาย พร้อมปกปิดกิจกรรมจากระบบตรวจสอบได้ในเวลาเดียวกัน แต่ก็ยอมรับว่าโมเดลในอนาคตอาจค้นพบจุดอ่อนที่ยังไม่เป็นที่รู้จักมาก่อน
OpenAI จึงนำการทดสอบแบบ Red Team อย่างต่อเนื่องมาเป็นส่วนหนึ่งของการประเมินความปลอดภัยก่อนฝึกและประเมินโมเดลรุ่นใหม่ เพื่อค้นหาจุดอ่อนและปรับปรุงมาตรการป้องกันให้ทันกับความสามารถของ AI ที่เพิ่มขึ้น